Role of parties in the vote distribution of proportional elections
L.E. Araripe, R.N. Costa Filho,Physica A 388 (2009) 4167–4170
ブラジル(1998,2002,2006)およびフィンランド(2003)の比例代表制選挙の得票率の分布を調べた論文。過去の研究ではブラジル、インドでは票数の分布がカットオフのあるべき分布ということが知られている。データはオンラインで公開[9][10]
解析結果は、得票率の分布は指数1のべき分布。得票率vの候補者数N(v)はvが1/1000か1/10のレンジで1/vで振る舞う。
この論文では政党お分布への影響を調べるために、政党毎の平均得票率v0を求め、v/v0の分布を調べた。v/v0=1の近くではデータは似た振る舞いをするが、ブラジルは指数分布でピークがなく、フィンランドは対数正規分布でv/v0=0.15にピークを持つ。このように、スケール不変性、普遍性が失われた。
2017年11月10日金曜日
備忘録:A spatial analysis of county-level outcomes in US Presidential elections:1988-2000
A spatial analysis of county-level outcomes in US Presidential elections: 1988–2000
Jeongdai Kim, Euel Elliott, Ding-Ming Wang,Electoral Studies 22 (2003) 741–761.
アメリカの大統領選挙の4回分のcountyレベルデータ(1988-2000)を用いて民主、共和党の得票率の空間パターンを明らかにした。空間パターンとして、境界を接するcounty間をつなぐ場合と、通勤データで5%以上の率を占めるcounty間をつなぐ場合とを考える。空間パターンを計測するために、都市部からの民主、共和への得票率の変化を調べ、民主が高いというurban biasを確認した。1988年では差は1.9%だが、2000年では8.9%になっている。また、MoranのIという、隣接するcounyの得票率をcountyの得票率で線形回帰したときの回帰係数を求め、1988年の0.5から2000年の0.6まで上昇していることを示した。MoranのIをcounty毎に計算したときのLocal Moran's Iを求め、countyと隣接countyのMoran's Iが高ー高(HH)、低ー低(LL)などのパターンの空間分布を調べたところ、民主がHHだと共和はLL、逆も真(例外は1992のペロー候補のときだが、1996には消滅)。東部と都市部は民主、西部は共和というパターンが確認できた。境界はミシシッピ川(ミネソタからルイジアナ)。この傾向は西部22州、東部27州でのHH,LLでの得票率の変化からも確認できる。
また、各countyの共和、民主の得票数をcountyの人口、失業率、所得で回帰するモデル(issue-priority model)を導入し、失業率が民主党の得票数を説明すること示した。ただし、90年代に入ると、回帰係数は小さくなり2000年では有意ではない。二期目の政権の得票数に対する回帰モデル(reward-punishment model)については、データが少ないため結論が出せない。
Jeongdai Kim, Euel Elliott, Ding-Ming Wang,Electoral Studies 22 (2003) 741–761.
アメリカの大統領選挙の4回分のcountyレベルデータ(1988-2000)を用いて民主、共和党の得票率の空間パターンを明らかにした。空間パターンとして、境界を接するcounty間をつなぐ場合と、通勤データで5%以上の率を占めるcounty間をつなぐ場合とを考える。空間パターンを計測するために、都市部からの民主、共和への得票率の変化を調べ、民主が高いというurban biasを確認した。1988年では差は1.9%だが、2000年では8.9%になっている。また、MoranのIという、隣接するcounyの得票率をcountyの得票率で線形回帰したときの回帰係数を求め、1988年の0.5から2000年の0.6まで上昇していることを示した。MoranのIをcounty毎に計算したときのLocal Moran's Iを求め、countyと隣接countyのMoran's Iが高ー高(HH)、低ー低(LL)などのパターンの空間分布を調べたところ、民主がHHだと共和はLL、逆も真(例外は1992のペロー候補のときだが、1996には消滅)。東部と都市部は民主、西部は共和というパターンが確認できた。境界はミシシッピ川(ミネソタからルイジアナ)。この傾向は西部22州、東部27州でのHH,LLでの得票率の変化からも確認できる。
また、各countyの共和、民主の得票数をcountyの人口、失業率、所得で回帰するモデル(issue-priority model)を導入し、失業率が民主党の得票数を説明すること示した。ただし、90年代に入ると、回帰係数は小さくなり2000年では有意ではない。二期目の政権の得票数に対する回帰モデル(reward-punishment model)については、データが少ないため結論が出せない。

2012年4月24日火曜日
競馬予想の精度4
前回は、日刊競馬の6名の予想をもとに、もっとも精度の高い競馬予想を行う方法として、精度(ここではAR=Accuarcy Ratioを用いています)が最大になるような手法を考えました。ただ、あるレースデータをもとにARを最大化しても、それを額面どおりに受け取ることはできません。では、どうするのかというと、ARの最大化に用いたレースデータとは別のレースデータを用意し、それでARを計算して比較します。つまり、学習データとパフォーマンスを計測するデータを別にするわけです。
そこで、学習データとして2010年3月27日から4月25日までの160レース2311頭のデータを用い、パフォーマンスの計算には、2010年5月1日から9日までの64レース927頭のデータを用いることにします。用いたデータは、以下のものです。
まず、学習データで、ARを最大化するポイント(本命、対抗などにつける点)を最大化すると、1:1: 1.4:1.9:2.4:2.9となり、ARは65.6%。ちなみに、前回述べたポイントが1:2:3:4:5:6の場合のARは65.1%なので、ARが大きくなるようにポイントが選ばれていることが分かります。以下、1:2:3:4:5:6のモデルをモデル0、ARを最大化したモデルをモデル1と呼ぶことにしましょう。問題は、モデル1がモデル0より予想精度が高くなっているのかどうかです。そこで、5月1日からの64レースのデータでARを比較してみることにします。
モデル0とモデル1でパフォーマンス比較を行ったときのROCカーブが下の図です。ARは、モデル0が61.0%、モデル1が60.5%となり、64レースとレース数が少ないので、確実に劣る(ARの差が優位)とまでは断言できませんが、すくなくともパフォーマンスが良くなってはいないことが分かります。
つまり、ARを最大化するようにポイントを動かした結果は過学習であって、新たなレースでの予測には使えないことが分かります。ちなみに、オッズのARは69.3%、6名の予想のARはそれぞれ44.6%,41.1%,46.5%,44.2%,55.0%,55.7%で、6名の平均のモデル0の精度が記者予想を5%以上上回っていることが分かります。
 しかし、オッズの予想精度には8%以上負けているわけで、この差を埋める、さらにはオッズに勝つにはどうすればいいのでしょう?この答えを求めるのが目標であり、そう簡単ではありません。そこで、競馬予想の精度をあげることを考える前に、すこし競馬予想の別の観点からの比較を行ってみることにしましょう。
そこで、学習データとして2010年3月27日から4月25日までの160レース2311頭のデータを用い、パフォーマンスの計算には、2010年5月1日から9日までの64レース927頭のデータを用いることにします。用いたデータは、以下のものです。
まず、学習データで、ARを最大化するポイント(本命、対抗などにつける点)を最大化すると、1:1: 1.4:1.9:2.4:2.9となり、ARは65.6%。ちなみに、前回述べたポイントが1:2:3:4:5:6の場合のARは65.1%なので、ARが大きくなるようにポイントが選ばれていることが分かります。以下、1:2:3:4:5:6のモデルをモデル0、ARを最大化したモデルをモデル1と呼ぶことにしましょう。問題は、モデル1がモデル0より予想精度が高くなっているのかどうかです。そこで、5月1日からの64レースのデータでARを比較してみることにします。
モデル0とモデル1でパフォーマンス比較を行ったときのROCカーブが下の図です。ARは、モデル0が61.0%、モデル1が60.5%となり、64レースとレース数が少ないので、確実に劣る(ARの差が優位)とまでは断言できませんが、すくなくともパフォーマンスが良くなってはいないことが分かります。
つまり、ARを最大化するようにポイントを動かした結果は過学習であって、新たなレースでの予測には使えないことが分かります。ちなみに、オッズのARは69.3%、6名の予想のARはそれぞれ44.6%,41.1%,46.5%,44.2%,55.0%,55.7%で、6名の平均のモデル0の精度が記者予想を5%以上上回っていることが分かります。

2012年4月15日日曜日
競馬予想の精度3
日刊競馬の予想印をもとに、競馬予想を行うベストな方法の結果です。前回は、2010年3月28日(日)の新聞にのった予想印の予想精度を、ARという指標で評価してみました。たった、18レースだったこともあり、オッズよりも精度が高い予想者の方もいて、すこし驚きました。私の想定では、オッズの精度がもっともよく、専門家の予想精度はそれに劣るはずだったからです。ただ、ARをもとに精度の比較を行うなら、最低50レースは必要。クレジットリスクの論文では、最低50のデフォルトがないと、比較できない、とあるので、競馬の場合なら50頭の勝ち馬=50レースとなるわけです。そこで、まず、データを2010年3月27日(土)から2010年4月11日(日)までの、土日6日分。レース数にして96レースのデータを作りました。日刊競馬のサイトでは、過去記事のpdfファイルを200円で販売していて、それを利用。本命1、対抗2から無印を6と番号を振り、あと意味不明は星印は7としています。それをJRA-VANのレースコードを振り、レースコード、馬番号、着順、6名の記者予想、オッズの10列のデータとしました。前回の一日分のデータでは、予想者が異なるレースが2レース含まれていたので、今回は、その点も注意してデータ化しています。

まずは、6名の記者予想と、オッズのARの比較です。6名の予想者それぞれの予想のARは、56.3%(柏木)、50.3%(宮崎)、59.1%(黒津)、39.2%(久保木)、51.9%(桧原)、60.0%(本誌飯田)。一方、オッズの予想精度は、68.2%となり、私の想定通り、オッズの精度が最高で、専門家の予想はそれに劣ることがわかります。
では、前回の課題の結果です。課題は、予想印の点を、本命1、対抗2、穴馬3とするのではなく、ARが最大になるように決めるというものでした。さらに、6名の記者の予想の混ぜ方の比率を変える、や、オッズの数値も点数として混ぜるなど、いろいろな条件でARを最大化することが考えられます。この場合、ARは、こうした点数や混ぜ方の関数となります。予想印だけを考える場合、本命の点を1に固定すると、そのあと対抗から無印までの5個の点(星印はよくわからないので、無印として扱いました)の関数、つまり5変数関数となります。さらに、6名の記者の混ぜ方を考えると、6個の比率という変数が加わりますが、比率の和は1なので、実質的には5個の追加となり、10変数関数ということになります。さらにオッズが加わると、その重みも入り11変数関数となります。
こうした多変数関数を最大化するには、通常「最速降下法」など、関数のそれぞれの変数方向の傾きの情報を使って、変数の値を徐々に変えていくのですが、それには傾き=微分を計算しないといけない。普通の多変数関数の場合、微分を適当に差分で置き換えてやればいいのですが、ARの場合は、そう簡単ではありません。ARはもともと、序列の完成度を数値化したものなので、パラメータの微小な変化に対して、変化せず、微分が計算できないのです。例えば、対抗の馬の点を2から2.001に変えても、ARが変わらないと予想できます。
そこで、ここでは「焼きなまし法」という手法を用いることにします。これは、微分の情報を使わず、変数を少し変えたときの、ARの変化をもとに、その変数の変化を採用するかどうかを確率的に決めることに基づいた手法で、もともとは統計物理学で生まれた手法です。その詳細は、Wikipediaなどに任せるとして、その結果だけ示すことにします。

三つのケースを考えています。ひとつは、前回も述べた、得点は1,2,3,4,5,6で、6名の予想を平均したもの(Model1)。次は、点を変えたもの(Model2)。最後は、6名の予想者の比率をARが最大になるように変えたもの(Model3)。まず、単純な平均では、ARは65.1%で、6名の予想のARが39.2%から60.0%だったことを考えると、その予想精度を5%も向上させていることがわかります。一方、点を変えた場合、ARは65.8%で、単純な点のModel1からのパフォーマンスの向上は0.7%で1%を切っています。最後のModel3では、6名の予想をうまく混ぜてARを最大化したのでオッズよりもARが大きくなっています。
では、このModel3を使えば、オッズよりも優秀な競馬予想が可能なのでしょうか?もちろん、そうではありません。この結果は、単に勝ち負けの結果をもとに、ARが最大になる組み合わせを決めただけであって、それは本当に精度が高いかどうかは、別のデータで検証する必要があります。そこで、次回は、次の3週分(4月17日から5月2日)のデータをもとに、このModel3の予想精度を検証してみましょう。
卒研の課題:ARを最大化するプログラムを書き、上記の結果を再現せよ。とりあえず、Model2なら、焼きなまし法でなくても、For ループを5回やれば出来ます。頭のいい方法ではもちろんありません。次の土曜日に、焼きなまし法の解説をします。
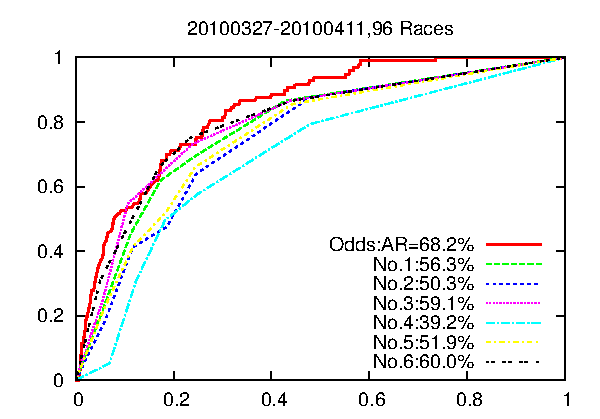
まずは、6名の記者予想と、オッズのARの比較です。6名の予想者それぞれの予想のARは、56.3%(柏木)、50.3%(宮崎)、59.1%(黒津)、39.2%(久保木)、51.9%(桧原)、60.0%(本誌飯田)。一方、オッズの予想精度は、68.2%となり、私の想定通り、オッズの精度が最高で、専門家の予想はそれに劣ることがわかります。
では、前回の課題の結果です。課題は、予想印の点を、本命1、対抗2、穴馬3とするのではなく、ARが最大になるように決めるというものでした。さらに、6名の記者の予想の混ぜ方の比率を変える、や、オッズの数値も点数として混ぜるなど、いろいろな条件でARを最大化することが考えられます。この場合、ARは、こうした点数や混ぜ方の関数となります。予想印だけを考える場合、本命の点を1に固定すると、そのあと対抗から無印までの5個の点(星印はよくわからないので、無印として扱いました)の関数、つまり5変数関数となります。さらに、6名の記者の混ぜ方を考えると、6個の比率という変数が加わりますが、比率の和は1なので、実質的には5個の追加となり、10変数関数ということになります。さらにオッズが加わると、その重みも入り11変数関数となります。
こうした多変数関数を最大化するには、通常「最速降下法」など、関数のそれぞれの変数方向の傾きの情報を使って、変数の値を徐々に変えていくのですが、それには傾き=微分を計算しないといけない。普通の多変数関数の場合、微分を適当に差分で置き換えてやればいいのですが、ARの場合は、そう簡単ではありません。ARはもともと、序列の完成度を数値化したものなので、パラメータの微小な変化に対して、変化せず、微分が計算できないのです。例えば、対抗の馬の点を2から2.001に変えても、ARが変わらないと予想できます。
そこで、ここでは「焼きなまし法」という手法を用いることにします。これは、微分の情報を使わず、変数を少し変えたときの、ARの変化をもとに、その変数の変化を採用するかどうかを確率的に決めることに基づいた手法で、もともとは統計物理学で生まれた手法です。その詳細は、Wikipediaなどに任せるとして、その結果だけ示すことにします。

三つのケースを考えています。ひとつは、前回も述べた、得点は1,2,3,4,5,6で、6名の予想を平均したもの(Model1)。次は、点を変えたもの(Model2)。最後は、6名の予想者の比率をARが最大になるように変えたもの(Model3)。まず、単純な平均では、ARは65.1%で、6名の予想のARが39.2%から60.0%だったことを考えると、その予想精度を5%も向上させていることがわかります。一方、点を変えた場合、ARは65.8%で、単純な点のModel1からのパフォーマンスの向上は0.7%で1%を切っています。最後のModel3では、6名の予想をうまく混ぜてARを最大化したのでオッズよりもARが大きくなっています。
では、このModel3を使えば、オッズよりも優秀な競馬予想が可能なのでしょうか?もちろん、そうではありません。この結果は、単に勝ち負けの結果をもとに、ARが最大になる組み合わせを決めただけであって、それは本当に精度が高いかどうかは、別のデータで検証する必要があります。そこで、次回は、次の3週分(4月17日から5月2日)のデータをもとに、このModel3の予想精度を検証してみましょう。
卒研の課題:ARを最大化するプログラムを書き、上記の結果を再現せよ。とりあえず、Model2なら、焼きなまし法でなくても、For ループを5回やれば出来ます。頭のいい方法ではもちろんありません。次の土曜日に、焼きなまし法の解説をします。
2012年3月20日火曜日
競馬予想の精度2
前回の課題の結果です。
課題のデータは、全部で18レース分です。
(本命1、対抗2、 単穴3、二重△4、△5、その他6としています。勝馬1、負け馬0。)
http://dl.dropbox.com/u/13984080/20120303_kadai.d
このデータを用いて、6名の予想者それぞれのARを計算するというものでした。結果は、6名の予想者それぞれの予想のARは、77.6%(柏木)、50.7%(宮崎)、60.4%(黒津)、49.0%(久保木)、74.7%(桧原)、73.0%(本誌飯田)。この18レースに関する限り、柏木氏の予想のARが77.6%で最高で、低い人は50%前後ということが分かります。もちろんこの傾向が、ずっと続くのか、それともタマタマだったのかは、レース数を増やさないと分からない。でも、素直な感想は、プロの予想は結構すばらしいというものです。最初の回で、競馬ファンの予想(オッズ)のARは約68%弱と書きました。その結果は何万レースでの予想の結果だったのですが、その数字と比較してもスバラシイ。
そこで、今回の課題です。
(1)前回入力した18レースのデータに、オッズのデータを追加する。
(2)オッズのARを計算し、上記の6名の予想のARとの比較を行う。
(3)6名の予想とオッズを用いて、ARがもっとも高い予想の作成を行う。
ここで、(3)の課題に対するヒントです。いろいろな予想があった場合、ひとつひとつの予想にはどうしてもバラつきがある。あるレースですばらしい予想をしても、別のレースでは完全に外したりして、全レースでなかなかピタリとあてるのは難しい。では、このバラつきを減らすにはどうすればいいのかというと、「単に平均をとればいい」というのが「集合知」でよく知られた事実です。そうすれば、ある馬に対し、ある予想ば過大評価、ある予想は過小評価しても、その平均をとると、過大評価と過小評価が相殺して、適正な評価が得られるわけです。
実際には、ある数値に対する個々人の評価は、正規分布のような左右対称に分布するわけではない。むしろ対数正規のような、過大評価側にテールが伸びている。つまり、むちゃくちゃ大きな値を予想する人が出てしまう。この場合、単純な平均(算術平均)では、バラつきをキャンセルできず、どうしてもバイアスが残ってしまう。J.Lorenz(2011,PNAS)の実験では、スイスの平均人口密度やスイスーイタリアの国境の長さなど6問について12人の被験者に予想してもらうという実験を行ったのですが、その結果を見ると、算術平均ではひどい結果でした。人口密度は実際は184名なのに、算術平均は2644名。こうした場合は、算術平均の代わりに幾何平均を使うのがいい。つまり、データの対数の平均をとるわけです。すると、対数正規分布は正規分布に代わり、左右対称になるので、あとは算術平均し、指数関数にいれて戻してやる。これは幾何平均と同じこと。その結果は132名で、ムチャクチャ大きな予想をした人の影響をうまく消して、真の値184名に結構近づいていることが分かります。
このように、問題によっては算術平均ではなく幾何平均を用いたり、いろいろ工夫する必要があるのですが、試しに「予想の平均」を計算して、それを用いてARを計算してみました。ある馬に対し、本命1、対抗2といった数値が6名分あるので、それを全部足して6で割って平均を計算。そして、数値の小さい順に馬を並べ替えて、ROCカーブを描き、AUROCを計算してARを求める。結果が次の図です。

すると、ARは81.4%となり、柏木氏の77.6%に勝っていることが分かります。ここで課題(3)に戻ると、本命=1、対抗=2と数値を決めていますが、この数値を動かす。また、オッズの数値も適当に変換し(定数倍)、それらの数値を用いてARが一番大きくなる「方程式」を導くというものです。
各自担当レースのオッズをデータに追加し、来週の土曜日に課題の結果を持ってくること。
課題のデータは、全部で18レース分です。
(本命1、対抗2、 単穴3、二重△4、△5、その他6としています。勝馬1、負け馬0。)
http://dl.dropbox.com/u/13984080/20120303_kadai.d
このデータを用いて、6名の予想者それぞれのARを計算するというものでした。結果は、6名の予想者それぞれの予想のARは、77.6%(柏木)、50.7%(宮崎)、60.4%(黒津)、49.0%(久保木)、74.7%(桧原)、73.0%(本誌飯田)。この18レースに関する限り、柏木氏の予想のARが77.6%で最高で、低い人は50%前後ということが分かります。もちろんこの傾向が、ずっと続くのか、それともタマタマだったのかは、レース数を増やさないと分からない。でも、素直な感想は、プロの予想は結構すばらしいというものです。最初の回で、競馬ファンの予想(オッズ)のARは約68%弱と書きました。その結果は何万レースでの予想の結果だったのですが、その数字と比較してもスバラシイ。
そこで、今回の課題です。
(1)前回入力した18レースのデータに、オッズのデータを追加する。
(2)オッズのARを計算し、上記の6名の予想のARとの比較を行う。
(3)6名の予想とオッズを用いて、ARがもっとも高い予想の作成を行う。
ここで、(3)の課題に対するヒントです。いろいろな予想があった場合、ひとつひとつの予想にはどうしてもバラつきがある。あるレースですばらしい予想をしても、別のレースでは完全に外したりして、全レースでなかなかピタリとあてるのは難しい。では、このバラつきを減らすにはどうすればいいのかというと、「単に平均をとればいい」というのが「集合知」でよく知られた事実です。そうすれば、ある馬に対し、ある予想ば過大評価、ある予想は過小評価しても、その平均をとると、過大評価と過小評価が相殺して、適正な評価が得られるわけです。
実際には、ある数値に対する個々人の評価は、正規分布のような左右対称に分布するわけではない。むしろ対数正規のような、過大評価側にテールが伸びている。つまり、むちゃくちゃ大きな値を予想する人が出てしまう。この場合、単純な平均(算術平均)では、バラつきをキャンセルできず、どうしてもバイアスが残ってしまう。J.Lorenz(2011,PNAS)の実験では、スイスの平均人口密度やスイスーイタリアの国境の長さなど6問について12人の被験者に予想してもらうという実験を行ったのですが、その結果を見ると、算術平均ではひどい結果でした。人口密度は実際は184名なのに、算術平均は2644名。こうした場合は、算術平均の代わりに幾何平均を使うのがいい。つまり、データの対数の平均をとるわけです。すると、対数正規分布は正規分布に代わり、左右対称になるので、あとは算術平均し、指数関数にいれて戻してやる。これは幾何平均と同じこと。その結果は132名で、ムチャクチャ大きな予想をした人の影響をうまく消して、真の値184名に結構近づいていることが分かります。
このように、問題によっては算術平均ではなく幾何平均を用いたり、いろいろ工夫する必要があるのですが、試しに「予想の平均」を計算して、それを用いてARを計算してみました。ある馬に対し、本命1、対抗2といった数値が6名分あるので、それを全部足して6で割って平均を計算。そして、数値の小さい順に馬を並べ替えて、ROCカーブを描き、AUROCを計算してARを求める。結果が次の図です。

各自担当レースのオッズをデータに追加し、来週の土曜日に課題の結果を持ってくること。
2012年3月3日土曜日
競馬予想の精度
これから競馬予想を作っていくわけですが、その目標は「勝ち馬をあてる」ことにあります。ただ、競馬でもうけるには、「この馬が勝ちそうだ」という予想では不十分で、その勝つ確率まで分からないとダメ。勝ちそうだという馬の「真の勝率」が3割だとして、その馬のオッズが3.4より低ければ、勝率とオッズの掛け算の結果は1以下となり、期待される返金額は掛けたお金以下、期待リターンはマイナスとなります。むしろ、勝率が1%であっても、その馬のオッズが100倍を超えているなら、期待される返金額は掛けたお金を上回り、期待リターンはプラスとなります。もっとも、勝率1%の馬か勝つことは100回に1回の比率でしかなく、そうした稀なチャンスを待つことはなかなか難しい。100円掛けるとしても100回待つには1万円は必要です。また100回待てば必ず1回勝つわけではなく、場合によっては200回やそれ以上待たないと勝たないかもしれない。そもそも「勝率は1%」と正確に評価することは難しい。
このように、競馬で儲けるには、勝馬予想だけでなく、その勝率まで必要です。しかし、いきなり勝率まで予想するのは難しいので、まずは勝ち馬予想の精度から始めることにしましょう。私の手元には2010年3月28日の「日刊競馬」というのがあり、1面は第40回高円宮記念(GI)の予想、解説となっています。4歳以上のオープンで、18頭が出走。過去八走の成績と、6人の予想印、見解と情報、スタッフ予想、能力指数、専門誌8社の予想などなど。非常にモリだくさん。ここで、予想印とは、◎や○、△、▲で示される予想のこと。◎が本命、○が対抗、▲が単穴で、△が連下と呼ばれ、この順番で強さが示されます。つまり、一番強いのが◎の本命、2番目に強いのが○という感じです。
 では、この予想印はどれほど正しいのでしょうか。単純に考えれば、◎の馬の勝ち数、○の馬の勝ち数などを求め、 それらが大きいほど、また△よりは▲、▲よりは○、○よりは◎という順番も加味した勝ち数が多いほどいい。例えば、10レース中「◎で5回1着で他は外れ」のほうが、「○で5回勝ち他は外れ」よりもすぐれた予想ということです。このように、印には◎が1番、○が2番、▲は3番、△は4番といった順番があり、同じ勝数を予想しても順番の高い印で勝ち数が多いほうが価値があるわけです。一方、馬にはレースでの着順という情報があるのですが、ここでは勝馬予想を考えているので、勝った、負けたというという二値の情報とし、勝ちを1、負けを0とします。すると、予想の精度は高い順番の印での1の数が多ければ高いことになります。では、その精度を数値化するのはどうすればよいのでしょうか。ここでは、AUROC(Area under ROC curve)と呼ばれるROCカーブの下側(under)の面積(area)から計算されるAR(Accuracy Ratio)を紹介します。
図を見てください。全部で3レースあり、各3頭出走し、全9頭の馬にそれぞれ本命◎、対抗○、単穴▲の印がついています。また、レースの結果の着順も示してあります(図の上段)。この情報を、中段に示された情報にまとめます。◎、○、▲の順番に馬を並べます。印の右下の数字がレース番号)が示されています。そして、印の下に、レース結果を書きます。馬が勝てば1、負ければ0とします。下段はROCカーブを示しています。中段の情報から下段のROCカーブを描くのには、次のようにします。今、◎の馬が3レース分で3頭いて、そのうち二頭が勝ち、1頭が負けたので、原点(0,0)からx軸に1、y軸に2進み、(1,2)と(0,0)を結びます。次に、○の馬3頭のうち、1頭が勝ち、2頭が負けなので、x軸に2、y軸に1すすんで、(3,3)に到達し、(1,2)と結びます。最後、▲の馬3頭は頭も勝っていないので、x軸に3、y軸に0すすんで、(6,3)に到達し、(3,3)と結びます。こうして、原点(0,0)と(6,3)を結ぶ折れ線が描かれましたが、これをROCカーブ(緑)です。このROCカーブの下側の面積AUROCは、横6縦3の長方形の面積18からカーブの上側部分の面積3をひいて15となります。
この面積と予想精度はどのような関係にあるのでしょう?まず、予想が完璧で本命馬◎がすべて勝った場合、ROCカーブは原点と(0,3)と(6,3)を結ぶ折れ線(赤点線)になります。この時の面積は18で、実際の予想での面積15より大きくなっています。逆に最悪の予想の場合、つまり本命、対抗が全敗し、▲が3頭とも勝った場合、ROCカーブは原点と(6,0)と(6,3)を結んだも(赤一点鎖線)のとなり、ROCカーブの面積は0となります。予想とレース結果に関係がない場合、◎、○、▲が一勝ずつとなりますが、このときのROCカーブは(0,0)と(6,3)を結んだ対角線(黄)となり、面積は18の半分の9となります。ARは、この予想が結果と全く関係がない場合の面積を基準とし、完全な場合に1となるように定義されています。上の予想の場合、予想のROCカーブの面積は15だったので、基準の面積9を引いて6とし、18(完璧)-9(基準)で割ることにより、ARは6/9となります。
では、実際の競馬予想の精度はどの程度なのでしょうか?今回の課題は、日刊競馬にある18レースの競馬予想の精度を求めることです。
①上図の例をデータファイルにし、読み込んでAUROC、ARを計算する。
②競馬新聞の予想をデータファイルにする。レース結果はYahoo!競馬で取得する。
③①のプログラムをもとに、②のデータで6人(柏木、宮崎、黒津、久保木、桧原、本誌飯田)の予想の精度(AR)を求める。
ヒント:次のプログラムを参考に
http://dl.dropbox.com/u/13984080/AR.c
図の例のデータファイルは
http://dl.dropbox.com/u/13984080/20120303.d
にあります。 データはCSV形式。レース番号、馬番号、徴の番号、着順です。
プログラムをコンパイルし、
./a.out 20120303.d ROC.d
とすると、ROCカーブのデータを作成し、ファイルROC.dに書き込みます。
gnuplotでプロットしてください。
gnuplotを起動し、
plot ROC.d w l lw 4
で、ROCカーブを描いてくれます。
課題のデータ入力をまとめたのでアップします。全部で18レース分です。
(本命1、対抗2、 単穴3、二重△4、△5、その他6としています。勝馬1、負け馬0。)
http://dl.dropbox.com/u/13984080/20120303_kadai.d
このデータを用いて6名の予想者それぞれのARを計算してください。
また、この情報をどのように活用すれば、よりARが高くなるか考えてください。
このように、競馬で儲けるには、勝馬予想だけでなく、その勝率まで必要です。しかし、いきなり勝率まで予想するのは難しいので、まずは勝ち馬予想の精度から始めることにしましょう。私の手元には2010年3月28日の「日刊競馬」というのがあり、1面は第40回高円宮記念(GI)の予想、解説となっています。4歳以上のオープンで、18頭が出走。過去八走の成績と、6人の予想印、見解と情報、スタッフ予想、能力指数、専門誌8社の予想などなど。非常にモリだくさん。ここで、予想印とは、◎や○、△、▲で示される予想のこと。◎が本命、○が対抗、▲が単穴で、△が連下と呼ばれ、この順番で強さが示されます。つまり、一番強いのが◎の本命、2番目に強いのが○という感じです。

図を見てください。全部で3レースあり、各3頭出走し、全9頭の馬にそれぞれ本命◎、対抗○、単穴▲の印がついています。また、レースの結果の着順も示してあります(図の上段)。この情報を、中段に示された情報にまとめます。◎、○、▲の順番に馬を並べます。印の右下の数字がレース番号)が示されています。そして、印の下に、レース結果を書きます。馬が勝てば1、負ければ0とします。下段はROCカーブを示しています。中段の情報から下段のROCカーブを描くのには、次のようにします。今、◎の馬が3レース分で3頭いて、そのうち二頭が勝ち、1頭が負けたので、原点(0,0)からx軸に1、y軸に2進み、(1,2)と(0,0)を結びます。次に、○の馬3頭のうち、1頭が勝ち、2頭が負けなので、x軸に2、y軸に1すすんで、(3,3)に到達し、(1,2)と結びます。最後、▲の馬3頭は頭も勝っていないので、x軸に3、y軸に0すすんで、(6,3)に到達し、(3,3)と結びます。こうして、原点(0,0)と(6,3)を結ぶ折れ線が描かれましたが、これをROCカーブ(緑)です。このROCカーブの下側の面積AUROCは、横6縦3の長方形の面積18からカーブの上側部分の面積3をひいて15となります。
この面積と予想精度はどのような関係にあるのでしょう?まず、予想が完璧で本命馬◎がすべて勝った場合、ROCカーブは原点と(0,3)と(6,3)を結ぶ折れ線(赤点線)になります。この時の面積は18で、実際の予想での面積15より大きくなっています。逆に最悪の予想の場合、つまり本命、対抗が全敗し、▲が3頭とも勝った場合、ROCカーブは原点と(6,0)と(6,3)を結んだも(赤一点鎖線)のとなり、ROCカーブの面積は0となります。予想とレース結果に関係がない場合、◎、○、▲が一勝ずつとなりますが、このときのROCカーブは(0,0)と(6,3)を結んだ対角線(黄)となり、面積は18の半分の9となります。ARは、この予想が結果と全く関係がない場合の面積を基準とし、完全な場合に1となるように定義されています。上の予想の場合、予想のROCカーブの面積は15だったので、基準の面積9を引いて6とし、18(完璧)-9(基準)で割ることにより、ARは6/9となります。
では、実際の競馬予想の精度はどの程度なのでしょうか?今回の課題は、日刊競馬にある18レースの競馬予想の精度を求めることです。
①上図の例をデータファイルにし、読み込んでAUROC、ARを計算する。
②競馬新聞の予想をデータファイルにする。レース結果はYahoo!競馬で取得する。
③①のプログラムをもとに、②のデータで6人(柏木、宮崎、黒津、久保木、桧原、本誌飯田)の予想の精度(AR)を求める。
ヒント:次のプログラムを参考に
http://dl.dropbox.com/u/13984080/AR.c
図の例のデータファイルは
http://dl.dropbox.com/u/13984080/20120303.d
にあります。 データはCSV形式。レース番号、馬番号、徴の番号、着順です。
プログラムをコンパイルし、
./a.out 20120303.d ROC.d
とすると、ROCカーブのデータを作成し、ファイルROC.dに書き込みます。
gnuplotでプロットしてください。
gnuplotを起動し、
plot ROC.d w l lw 4
で、ROCカーブを描いてくれます。
課題のデータ入力をまとめたのでアップします。全部で18レース分です。
(本命1、対抗2、 単穴3、二重△4、△5、その他6としています。勝馬1、負け馬0。)
http://dl.dropbox.com/u/13984080/20120303_kadai.d
このデータを用いて6名の予想者それぞれのARを計算してください。
また、この情報をどのように活用すれば、よりARが高くなるか考えてください。
2012年3月2日金曜日
競馬予想の作り方:はじめに
明日(2011年3月3日)から、平成24年度の卒業研究が始まるので、その実習テーマとして「競馬予想の作り方」をとりあげます。
内容は、以前、JWEIN2010の講演「競馬予想とは何か?」でも扱ったロジットモデルによって、単勝馬券の適正オッズを計算するというもの。その仕組みや、評価方法を解説しながら、競馬ファンによる予想(レースでの最終オッズ)の精度にどの程度迫れるのか、挑戦してみようと考えています。
平成22年度の入江君の卒業研究「競馬予想と集団知」では、スポーツ新聞の競馬予想の情報を加味してロジットモデルを最適化し、競馬ファンの予想(AR=Accuracy Ratio=67.8%)にほんのわずか(AR=65.4%)のところまで迫ることができました。さらに、競馬ファンのオッズの情報まで加えて、最適化すると、オッズよりほんのわずか高い精度(0.2%)で予想が作れそうだということも。
図がそのときの結果です。ロジット単独だと、ARは56.3%で、JRA-VANの順位予想(AR=50.5%)をファクターに入れて最適化すると58.9%。それにスポーツ新聞の予想もいれて最適化すると65.4%まで上がり、単勝馬券の最終得票率もいれて最適化したモデルのARは68.0%となり、競馬ファンの予想のARを0.2%上回っています。ただ、「+0.2%」は、あまりにも小さく、誤差の範囲内ともとれるレベル。また、最終の得票率の情報は実際のレースで入手することは無理なので、競馬ファンの予想に勝ったとは言えません(実際には、レース直前に大量の投票が行われても、予想精度そのものは大して変化しないので、出走30分前の得票率で十分のようですが)。
今回は、
①ロジット単独でスポーツ新聞よりも精度の高い予想を行うこと。
②スポーツ新聞の予想を加味したときに、競馬ファンの予想精度を上回ること
の二つを目標としています。
これらの目標を目指し、かつ卒業研究の実習をかねて、平成24年度の1年間、1週間に1度(土曜日)、競馬予想の課題とその結果についてこのブログに掲載していく予定です。
 どこまで続くかな分かりませんが、頑張れるだけやってみようと思います。何分、私は馬券を買ったこともなく、過去の文献などをもとにロジットモデルを作っているだけなので、どのようなファクターをモデルにいれるのがよいのかについてのアイデアがあまりありません。経験豊富な方からのアドバイスも歓迎します。よろしくお願いします。
内容は、以前、JWEIN2010の講演「競馬予想とは何か?」でも扱ったロジットモデルによって、単勝馬券の適正オッズを計算するというもの。その仕組みや、評価方法を解説しながら、競馬ファンによる予想(レースでの最終オッズ)の精度にどの程度迫れるのか、挑戦してみようと考えています。
平成22年度の入江君の卒業研究「競馬予想と集団知」では、スポーツ新聞の競馬予想の情報を加味してロジットモデルを最適化し、競馬ファンの予想(AR=Accuracy Ratio=67.8%)にほんのわずか(AR=65.4%)のところまで迫ることができました。さらに、競馬ファンのオッズの情報まで加えて、最適化すると、オッズよりほんのわずか高い精度(0.2%)で予想が作れそうだということも。
図がそのときの結果です。ロジット単独だと、ARは56.3%で、JRA-VANの順位予想(AR=50.5%)をファクターに入れて最適化すると58.9%。それにスポーツ新聞の予想もいれて最適化すると65.4%まで上がり、単勝馬券の最終得票率もいれて最適化したモデルのARは68.0%となり、競馬ファンの予想のARを0.2%上回っています。ただ、「+0.2%」は、あまりにも小さく、誤差の範囲内ともとれるレベル。また、最終の得票率の情報は実際のレースで入手することは無理なので、競馬ファンの予想に勝ったとは言えません(実際には、レース直前に大量の投票が行われても、予想精度そのものは大して変化しないので、出走30分前の得票率で十分のようですが)。
今回は、
①ロジット単独でスポーツ新聞よりも精度の高い予想を行うこと。
②スポーツ新聞の予想を加味したときに、競馬ファンの予想精度を上回ること
の二つを目標としています。
これらの目標を目指し、かつ卒業研究の実習をかねて、平成24年度の1年間、1週間に1度(土曜日)、競馬予想の課題とその結果についてこのブログに掲載していく予定です。

2010年1月21日木曜日
M.M.Ali 1977
Probability and Utility Estimate for racetrack Bettors, Journal of Political Economy 83(1977)803-815.
M.Weitzman(1965)はオッズ(リターン)に対する勝率を解析したのですが、それを人気(オッズの小さいものからの順番)に対して行った。また、F-Lバイアスの原因として、効用関数の凹性の他に、競馬ファンの考える勝率のゆらぎを指摘。また、レース後半で所持金が少なくなると、F-Lバイアスが大きくなる。
データは20247レースの繋駕速歩競走(けいがそくほきょうそう、harness horse race)
1.イントロダクション
心理学の実験で低確率の事象の頻度が過大評価され、高確率の事象の頻度が過小評価されると主張された。Griffith(1949)やMacGlothlin(1956)は競馬のデータから同様な結論を得たが、彼らのデータはわずか1500レース以下。M.Weitzman(1965)は12000レース以上でやり、以前の研究を確認+典型的競馬ファンの効用関数を評価した。
2.主観vs客観確率の評価
単勝を考える。H頭のレースで馬iに賭けられた額Xi、総額Wとする。aが競馬場の取り分と切り捨て分の和とすると、オッズAiはAi=((1-a)W-Xi)/Xi=(1-a)W/Xi-1となる。
馬hが勝つ主観確率は賭けられた額の比率Xi/W、客観確率はレースが無限回行われたときのその馬の勝つ比率。馬iの主観確率ρiはオッズから分かる。ρi=(1-a)/(1+Ai)。馬iの客観確率πiは一回の試行からは分からない。そこで馬をグループわけを行い、その平均主観確率と平均客観確率を比較する。同じグループの馬は、一頭の馬と考える。馬は人気でグループ化する。1番人気、2番人気という風に。人気をhで表し、ρhとπhを比較。人気hは1番から8番まで。すると、h=1ではπhはρhよりも大、h>=5では、逆πhはρhより小さいが成立。1番人気の馬では、主観確率よりも客観確率が上で、人気5以下の不人気馬では逆に主観確率ほど客観確率は高くなく、F-Lバイアスが確認された。
3.F-Lバイアスの説明
(1)心理学的なもの
(2)競馬ファンはリスク選好
競馬ファンは合理的(=損な行動はしない)で馬の勝率を知っていてリスク選好であるとすると、期待効用仮説とも一致。ただし、効用関数は凹。ただし、このアイデアは矛盾する場合がある。効用関数はひとつのレースで馬券を買うときのみ、と限定すれば問題なし。
(3)馬の勝率の知識にバラツキがある+リスク中立+合理的でも説明可能。
4.効用関数(Implied Utility Function)
競馬ファンは期待効用関数を最大化&勝率を知る&ひとつのレースに限定すると仮定((2)の場合)して、レースデータから効用関数を評価する。Implied効用関数と呼ぶ。結果は、リターンの増加とともに増加率が上昇する、リスク選好タイプであることが分かった。

効用関数をu(x)と書く。人気hに対する真の勝率πh、平均オッズah。所持金をXo。
人気hに賭けたときの効用関数の期待値は、
Eh(u)=(1-πh)u(Xo-1)+πh[u((Xo-1)+(1+ah))]
ahは最終オッズなので、どの人気hの期待値も同じになる。
E1(u)=E2(u)=E3(u)=E4(u)=E5(u)E6(u)=E7(u)=E8(u)
Xo-1=0、u(0)=0,u(1+a8)=1と選ぶと、u(1+ah)=π8/πhとなる。リターンx=1+ahとすると、log u(x)=0.2794(0.0200)+1.1784log x(R^2=0.9981)でフィットできる。u(x)=1.91*x^{1.1784}となり、凹な関数となる。
M.Weitzman(1965)はオッズ(リターン)に対する勝率を解析したのですが、それを人気(オッズの小さいものからの順番)に対して行った。また、F-Lバイアスの原因として、効用関数の凹性の他に、競馬ファンの考える勝率のゆらぎを指摘。また、レース後半で所持金が少なくなると、F-Lバイアスが大きくなる。
データは20247レースの繋駕速歩競走(けいがそくほきょうそう、harness horse race)
1.イントロダクション
心理学の実験で低確率の事象の頻度が過大評価され、高確率の事象の頻度が過小評価されると主張された。Griffith(1949)やMacGlothlin(1956)は競馬のデータから同様な結論を得たが、彼らのデータはわずか1500レース以下。M.Weitzman(1965)は12000レース以上でやり、以前の研究を確認+典型的競馬ファンの効用関数を評価した。
2.主観vs客観確率の評価
単勝を考える。H頭のレースで馬iに賭けられた額Xi、総額Wとする。aが競馬場の取り分と切り捨て分の和とすると、オッズAiはAi=((1-a)W-Xi)/Xi=(1-a)W/Xi-1となる。
馬hが勝つ主観確率は賭けられた額の比率Xi/W、客観確率はレースが無限回行われたときのその馬の勝つ比率。馬iの主観確率ρiはオッズから分かる。ρi=(1-a)/(1+Ai)。馬iの客観確率πiは一回の試行からは分からない。そこで馬をグループわけを行い、その平均主観確率と平均客観確率を比較する。同じグループの馬は、一頭の馬と考える。馬は人気でグループ化する。1番人気、2番人気という風に。人気をhで表し、ρhとπhを比較。人気hは1番から8番まで。すると、h=1ではπhはρhよりも大、h>=5では、逆πhはρhより小さいが成立。1番人気の馬では、主観確率よりも客観確率が上で、人気5以下の不人気馬では逆に主観確率ほど客観確率は高くなく、F-Lバイアスが確認された。
3.F-Lバイアスの説明
(1)心理学的なもの
(2)競馬ファンはリスク選好
競馬ファンは合理的(=損な行動はしない)で馬の勝率を知っていてリスク選好であるとすると、期待効用仮説とも一致。ただし、効用関数は凹。ただし、このアイデアは矛盾する場合がある。効用関数はひとつのレースで馬券を買うときのみ、と限定すれば問題なし。
(3)馬の勝率の知識にバラツキがある+リスク中立+合理的でも説明可能。
4.効用関数(Implied Utility Function)
競馬ファンは期待効用関数を最大化&勝率を知る&ひとつのレースに限定すると仮定((2)の場合)して、レースデータから効用関数を評価する。Implied効用関数と呼ぶ。結果は、リターンの増加とともに増加率が上昇する、リスク選好タイプであることが分かった。

効用関数をu(x)と書く。人気hに対する真の勝率πh、平均オッズah。所持金をXo。
人気hに賭けたときの効用関数の期待値は、
Eh(u)=(1-πh)u(Xo-1)+πh[u((Xo-1)+(1+ah))]
ahは最終オッズなので、どの人気hの期待値も同じになる。
E1(u)=E2(u)=E3(u)=E4(u)=E5(u)E6(u)=E7(u)=E8(u)
Xo-1=0、u(0)=0,u(1+a8)=1と選ぶと、u(1+ah)=π8/πhとなる。リターンx=1+ahとすると、log u(x)=0.2794(0.0200)+1.1784log x(R^2=0.9981)でフィットできる。u(x)=1.91*x^{1.1784}となり、凹な関数となる。
2010年1月18日月曜日
M.Weitzman 1965
Utility Analysis and Group Behavior An Empirical Study, Journal of Political Economy 73(1965), 18-26.
競馬ファンの効用関数をデータから求めた最初の論文です。
1.イントロダクション
現在まで効用関数の実証的な研究は、実験室の中の小さなグループを対象としたものが主だった。この論文では、競馬ファンの集団の投票行動の多量なデータを用いて効用関数を研究する。”競馬における平均的な人”(average man at the racetrack" という概念を導入し、その意思決定のメカニズム、さまざまなリスクの組み合わせに対する無差別曲線、お金の効用曲線を与える。
2.期待効用仮説
根本的な仮定は、おのおのは非常によい近似で自分の効用関数を最大にするように振る舞う。mドルを確率pで得る状況の効用関数をU(p,m)とすると、期待効用仮説とは、U(p,m)=p×u(m)となること。ここで、u(m)はmドルの効用。Friedman&Savage(1948)はお金の効用カーブu(m)は、凸凹していると保険に入る一方で、ギャンブルするといったリスクに対する一見矛盾した行動を説明できると主張。Markowitz(1952)はそれを修正。mがc以上a以下では、カーブは下に凸。それ以上だと上に凸とした。aは変局点で、個人のリスクに対する嗜好性で決まり、cは現在の所得。この研究では、cからaまでの領域の効用関数の評価を行う。
3.データ解析
ニューヨーク、1954-1963の10年間、12000レース以上、110000頭以上のデータ。
合理的な競馬ファンは、リスクに対する態度を考えると、オッズ(リターン)が教えるよりも高い確率で勝つ馬を選択する。ここでは、リターンと実際の勝つ確率の間の関係に着目する。
4. 結果
リターンxの関数としての馬の勝率pを計算した。(x,p)の組は257個。 重みつき最小二乗法でフィット。直角双曲線p=A/xのフィットはかなりよく、決定値R^2は0.9807,A=0.8545(±0.0075)
p=A/x+Blog(1+x)/xはさらによく、決定値R^2は0.9852,A=1.011(±0.0190),B=-0.087(±0.0099)
で、こちらを採用。

5. Avmart氏の定式化
人工的に導入した一様な競馬ファンのことを"Mr. Avmart(Average man at the racetrack"と呼ぶ。多数のMr.Avmartが買う馬券は競馬ファン全体で買う馬券と一致する。競馬ファン全体を擬人化したもの。
6.Avmartの無差別曲線
関係p(x)は、オッズxを5倍すると、現実のAvmartのリターンと確率の無差別曲線になる。なぜなら、1レースに大体5ドルかけるから。p(mドル)=p(x=m/5)はAvmartの等効用曲線。曲線上の任意の2点A(m1,p1),B(m2,p2)の効用は同じ。1/xがp(x)のかなりよい近似であるというのは重要である。Avmartが期待効用仮説を支持していることを示す。
7.Avmartのお金の効用曲線u(m)
Avmartが期待効用仮説に従うならば、彼のお金の効用関数を決定できる。ある定数Kを用いてp(m)×u(m)=Kが成立するので、u(m)=K/p(m)となる。p(m)=5A/m+5Blog(1+m/5)/mを代入する。結果、u''(m)>0 が5≦m≦500で成立し、下に凸であることがわかる。u''の値はm=500ドルでm=5ドルの100分の1以下なので、十分大きなmでu''=0となり、上に凸な領域に変化するのかもしれない。

8. 結論
競馬ファンはMarkowitzが仮定した下に凸な効用関数をもった個人の集団のように振る舞う。
競馬ファンの効用関数をデータから求めた最初の論文です。
1.イントロダクション
現在まで効用関数の実証的な研究は、実験室の中の小さなグループを対象としたものが主だった。この論文では、競馬ファンの集団の投票行動の多量なデータを用いて効用関数を研究する。”競馬における平均的な人”(average man at the racetrack" という概念を導入し、その意思決定のメカニズム、さまざまなリスクの組み合わせに対する無差別曲線、お金の効用曲線を与える。
2.期待効用仮説
根本的な仮定は、おのおのは非常によい近似で自分の効用関数を最大にするように振る舞う。mドルを確率pで得る状況の効用関数をU(p,m)とすると、期待効用仮説とは、U(p,m)=p×u(m)となること。ここで、u(m)はmドルの効用。Friedman&Savage(1948)はお金の効用カーブu(m)は、凸凹していると保険に入る一方で、ギャンブルするといったリスクに対する一見矛盾した行動を説明できると主張。Markowitz(1952)はそれを修正。mがc以上a以下では、カーブは下に凸。それ以上だと上に凸とした。aは変局点で、個人のリスクに対する嗜好性で決まり、cは現在の所得。この研究では、cからaまでの領域の効用関数の評価を行う。
3.データ解析
ニューヨーク、1954-1963の10年間、12000レース以上、110000頭以上のデータ。
合理的な競馬ファンは、リスクに対する態度を考えると、オッズ(リターン)が教えるよりも高い確率で勝つ馬を選択する。ここでは、リターンと実際の勝つ確率の間の関係に着目する。
4. 結果
リターンxの関数としての馬の勝率pを計算した。(x,p)の組は257個。 重みつき最小二乗法でフィット。直角双曲線p=A/xのフィットはかなりよく、決定値R^2は0.9807,A=0.8545(±0.0075)
p=A/x+Blog(1+x)/xはさらによく、決定値R^2は0.9852,A=1.011(±0.0190),B=-0.087(±0.0099)
で、こちらを採用。

5. Avmart氏の定式化
人工的に導入した一様な競馬ファンのことを"Mr. Avmart(Average man at the racetrack"と呼ぶ。多数のMr.Avmartが買う馬券は競馬ファン全体で買う馬券と一致する。競馬ファン全体を擬人化したもの。
6.Avmartの無差別曲線
関係p(x)は、オッズxを5倍すると、現実のAvmartのリターンと確率の無差別曲線になる。なぜなら、1レースに大体5ドルかけるから。p(mドル)=p(x=m/5)はAvmartの等効用曲線。曲線上の任意の2点A(m1,p1),B(m2,p2)の効用は同じ。1/xがp(x)のかなりよい近似であるというのは重要である。Avmartが期待効用仮説を支持していることを示す。
7.Avmartのお金の効用曲線u(m)
Avmartが期待効用仮説に従うならば、彼のお金の効用関数を決定できる。ある定数Kを用いてp(m)×u(m)=Kが成立するので、u(m)=K/p(m)となる。p(m)=5A/m+5Blog(1+m/5)/mを代入する。結果、u''(m)>0 が5≦m≦500で成立し、下に凸であることがわかる。u''の値はm=500ドルでm=5ドルの100分の1以下なので、十分大きなmでu''=0となり、上に凸な領域に変化するのかもしれない。

8. 結論
競馬ファンはMarkowitzが仮定した下に凸な効用関数をもった個人の集団のように振る舞う。
2010年1月11日月曜日
R.M.Griffith 1949 & 1961

Odds Adjustment by American Horse-Race Bettors
American Jornal of Psycology,62(1949)290-294.
競馬においてさまざまな馬のオッズとは賭けられたお金の総額に比例し、それゆえ社会的に決まるものである。一方、さまざまなオッズレベルの馬の勝ちの客観的確率は事後に勝ち馬の比率で決められる。オッズは心理学的な確率(の逆数)を表し、任意のオッズでの勝ち馬の比率は真の確率を計測する。両者の系統的な差は競馬における賭けという特殊なトピックに光を投げかけるだけでなく確率の心理学というより一般的な分野の理解にもつながるものだ。
データは1947年春の519レースと8月の867レースの計1386レース、
「勝ち馬の数×オッズ=そのオッズの馬の数」?を検証した。オッズは寺銭、切捨てなどを補正。左辺が馬の数を超えるならその(心理学的な)オッズは過大評価、以下なら過小評価。
結果は、左辺と右辺をオッズレベルに対してプロットすると二つのカーブはほぼ一致する。細かく見ると、オッズが小の部分で左辺が右辺の上、オッズが大の部分で左辺が右辺の下にくる。オッズが6.1でで交わる。
まとめ
(1)社会的に決まるオッズは平均して馬の勝率を正確に反映する。
(2)しかし、オッズが小さい部分では勝率の過小評価、大きい部分では過大評価がある。
(3)オッズが6.1で切り替わる。
(4)Preston and Baratta が大きな確率を過小評価、小さな確率を過大評価するする系統的な傾向を実験で検証したが、その切り替わる確率の値は5%から25%で(3)とも符合する。
A Footnote on Horse Race Betting,Transactions Kentucky Academy of Science,22(1961)22,78-81.
データは1949年5月、1960年8月のデータ。単勝オッズが3倍以下。
もっとも勝率の高い馬の勝率の過小評価の傾向は複勝の場合にもっとも顕著になるはずだ。
結果は、単勝のオッズが1.4以下の馬の複勝の馬券は過小評価され、寺銭、切捨てを考慮してももうかるレベル。1949年だと1ドルに対し6.15セント、1960年だと1ドルで2.4セントの利益。
2010年1月7日木曜日
Part VII: 英国連邦とアジアの競馬市場
英国や他のオーストラリア、ニュージーランドなどの英国連邦、そしてイタリア、フランスなどのヨーロッパの国々では固定オッズ方式が主に採用されている。ブックメイカーがオッズを提供し、馬券のオッズは買ったときにオファーされたオッズでロックインされ、その後オファーされるオッズが変わっても変化しない。
胴元が最後に提供するレース直前のオッズ(SP)で効率性を検証するとF-Lバイアスが見られる。もっとも権威のあるSporting Lifeの発表するオッズ(FP)はレースのかなり前のものである。単勝オッズをFP/SPの値で分類し、FP/SPのレンジでの期待リターンを比較した(FP/SP比率はオッズの変化の指標)ところ、FP/SPが大きい(人気馬にさらに票が集中)ならば、期待リターンは正で平均よりはよいが、FP/SPが小さい場合、期待リターンは負となった。この結果は人気馬の場合にさらに顕著になる。
胴元が最後に提供するレース直前のオッズ(SP)で効率性を検証するとF-Lバイアスが見られる。もっとも権威のあるSporting Lifeの発表するオッズ(FP)はレースのかなり前のものである。単勝オッズをFP/SPの値で分類し、FP/SPのレンジでの期待リターンを比較した(FP/SP比率はオッズの変化の指標)ところ、FP/SPが大きい(人気馬にさらに票が集中)ならば、期待リターンは正で平均よりはよいが、FP/SPが小さい場合、期待リターンは負となった。この結果は人気馬の場合にさらに顕著になる。
Part VI:.エキゾティック馬券市場の効率性
2頭以上の馬に賭ける馬券をエキゾティック馬券という。馬連、馬単、3連単、ダブルなど、さまざまな種類のものが売られている。エキゾティック馬券は競馬ファンには人気がある。魅力の一部はそのリスク・リターンのトレードオフ、つまり勝つ確率はとても低いが払い戻しが高いことにある。単勝馬券に対するF-Lバイアスのことを考えると、大きなオッズの馬券が買われすぎているということは驚くに値しない。
Benterはエキゾティック馬券の魅力として次の理由をあげている。どの馬券市場でも勝つためには平均的な競馬ファンにまさる順位予想技術が必要だが、単勝馬券よりもエキゾティック馬券のほうがその差は少なく比較的容易である。多くの競馬場ではこの差を考慮して、エキゾティック馬券の主催者取り分(寺銭)を増やしている。
Asch and Quandt(1987)はエキゾティック馬券には「情報通の投資家の金」(smart money)が存在していると報告。競馬ファンにとってエキゾティック馬券市場のほうが、単勝馬券市場よりも難しいと考えられるからである。Bacon-Shone, Lo and Busch(1992)は馬単、3連単の投票はある順序での着順確率(順序確率)の高精度の評価であり、単勝市場よりも精度が高いことを示した。
Hausch, Lo and Ziemba(1994)はエキゾティック馬券の場合の最適な賭け方の一般公式を開発した。この手法はどんなエキゾティック馬券にでも使える。
ポスト位置は通常ランダムに決まる。先行馬の場合のように、内側のポスト番号が有利な状況もある。Canfield, Fauman and Ziemba(1987)は単勝やエキゾティック馬券の場合の効率性を調べるのにポスト位置バイアスを考慮した。カナダの3年分のレースデータを用いて、内側有利で外側不利という結果を得た。さらに、そのバイアスはトラックの外周が短くなれば周回数が増え、さらに顕著になる。しかし、競馬ファンは有利だと思うポスト番号を買いすぎるので、その有利さを打ち消してしまう。競馬場は傾斜角がついていて、雨が降ると柵近くに水がたまる。そうした悪い馬場の場合はポスト番号によるバイアスを本質的に打ち消してしまう。
Benterはエキゾティック馬券の魅力として次の理由をあげている。どの馬券市場でも勝つためには平均的な競馬ファンにまさる順位予想技術が必要だが、単勝馬券よりもエキゾティック馬券のほうがその差は少なく比較的容易である。多くの競馬場ではこの差を考慮して、エキゾティック馬券の主催者取り分(寺銭)を増やしている。
Asch and Quandt(1987)はエキゾティック馬券には「情報通の投資家の金」(smart money)が存在していると報告。競馬ファンにとってエキゾティック馬券市場のほうが、単勝馬券市場よりも難しいと考えられるからである。Bacon-Shone, Lo and Busch(1992)は馬単、3連単の投票はある順序での着順確率(順序確率)の高精度の評価であり、単勝市場よりも精度が高いことを示した。
Hausch, Lo and Ziemba(1994)はエキゾティック馬券の場合の最適な賭け方の一般公式を開発した。この手法はどんなエキゾティック馬券にでも使える。
ポスト位置は通常ランダムに決まる。先行馬の場合のように、内側のポスト番号が有利な状況もある。Canfield, Fauman and Ziemba(1987)は単勝やエキゾティック馬券の場合の効率性を調べるのにポスト位置バイアスを考慮した。カナダの3年分のレースデータを用いて、内側有利で外側不利という結果を得た。さらに、そのバイアスはトラックの外周が短くなれば周回数が増え、さらに顕著になる。しかし、競馬ファンは有利だと思うポスト番号を買いすぎるので、その有利さを打ち消してしまう。競馬場は傾斜角がついていて、雨が降ると柵近くに水がたまる。そうした悪い馬場の場合はポスト番号によるバイアスを本質的に打ち消してしまう。
Part V:複勝馬券(place,show)市場の効率性
競馬研究のほとんどは単勝市場に関するものであり、一般的な結論はF-Lバイアスは存在
するが、正のリターンを与えるほどではなく、弱い意味で効率的な市場です。複勝馬券市場での非効率性はGriffith(1961)により報告された。いくつかの説明がある。1)規模が小さい、2)着順により様々な払い戻しがあり単勝より複雑なの、3)単勝のF-Lバイアスのため。
Hausch, Ziemba and Rubinstein(1981)は複勝での非効率性を見つけようとした。最終オッズでHarvilleモデルを適用し2,3着の確率を計算し、期待リターンを計算した。結果10%のオーダーのリターンを示した。Ritter(1994)は単勝得票率と複勝得票率を比較し、差が十分大きいときに賭けるというルールを試した。最終オッズを用いた場合は正の利益を得たが、1分30秒前のオッズだとうまくいかなかった。
Hausch and Ziemba(1990)は超人気馬が存在する場合の裁定取引を考え、鉄板(LOCK)が存在する場合に保障されたリターンを最大化するようにした。
するが、正のリターンを与えるほどではなく、弱い意味で効率的な市場です。複勝馬券市場での非効率性はGriffith(1961)により報告された。いくつかの説明がある。1)規模が小さい、2)着順により様々な払い戻しがあり単勝より複雑なの、3)単勝のF-Lバイアスのため。
Hausch, Ziemba and Rubinstein(1981)は複勝での非効率性を見つけようとした。最終オッズでHarvilleモデルを適用し2,3着の確率を計算し、期待リターンを計算した。結果10%のオーダーのリターンを示した。Ritter(1994)は単勝得票率と複勝得票率を比較し、差が十分大きいときに賭けるというルールを試した。最終オッズを用いた場合は正の利益を得たが、1分30秒前のオッズだとうまくいかなかった。
Hausch and Ziemba(1990)は超人気馬が存在する場合の裁定取引を考え、鉄板(LOCK)が存在する場合に保障されたリターンを最大化するようにした。
Part IV:単勝市場の効率性とF-Lバイアス
株式市場の効率性の検証と同じ手法で競馬市場の効率性の検証が可能である。ほとんどの研究者は単勝馬券市場に集中し、単勝馬券の得票率が真の勝率の正確な評価になっているかどうかを研究した。もしそうなら、競馬ファンが期待リターンを最大化するという仮定と一致する。
Griffith(1949)やMcGlothlin(1956)らが単勝市場を解析し、人気馬(Favorite)のオッズが勝率を過小評価し、不人気馬(Longshot)のオッズが勝率を過大評価するというF-Lバイアスを見出した。そうしたバイアスはリスク選好の仮定と一致する。
Snyder(1978)はWeak Form Test(オッズの知識をもとに平均リターンを超えられるか)とStrong Form Test(予想記者のような特別なグループが他の人々よりうわまわるか)を行った。彼のStrong Form TestはSemi-Strong Form Testと考えたほうがいいかも知れない。なぜなら、個人的に得られた情報ではなく出版された専門家の予想をもとにしたリターンと関係があるからである。Weak-Formの効率性は検証された。たしかに、F-Lバイアスは存在するが主催者の取り分を上回るほどではないからである。(Semi-)Strong Formに関しては、公式または非公式の予想記者によるバイアスは一般人によるものより大きい。
Figlewski(1979)は多項ロジットモデルで勝率と予想記者と最終オッズを関係付けた。予想記者の助言はかなりの情報を含んでいるがオッズがほぼ全てを割り引いてしまう。しかし、場外投票の場合は予想記者の主観的情報を完全には割り引いていない。Losey and Talbott(1980)はSynder(1978)のデータを解析し、予想記者を信じている競馬ファンは平均的リターンを得られないばかりかそれ以下であるとした。
Asch,Malkiel and Quandt(1982)は人気でのF-Lバイアスに加え、予想オッズより最終オッズのほうが勝率を評価するのに正確であると指摘。それは驚くべきことではない。なぜなら、オッズは大多数の人々のコンセンサスなのに対し、予想オッズは数名の予想記者が発表したもので、レースのスタートよりかなり以前だからである。
F-Lバイアスは弱くて現実的なリターンを生まないかもしれないが、その存在は説明する価値がある。合理的な投票者にもとづく2つのアプローチはリスク選好の競馬ファンの存在にもとづくものと確率に関する評価の分散を考慮するものである。
Griffith(1949)やMcGlothlin(1956)らが単勝市場を解析し、人気馬(Favorite)のオッズが勝率を過小評価し、不人気馬(Longshot)のオッズが勝率を過大評価するというF-Lバイアスを見出した。そうしたバイアスはリスク選好の仮定と一致する。
Snyder(1978)はWeak Form Test(オッズの知識をもとに平均リターンを超えられるか)とStrong Form Test(予想記者のような特別なグループが他の人々よりうわまわるか)を行った。彼のStrong Form TestはSemi-Strong Form Testと考えたほうがいいかも知れない。なぜなら、個人的に得られた情報ではなく出版された専門家の予想をもとにしたリターンと関係があるからである。Weak-Formの効率性は検証された。たしかに、F-Lバイアスは存在するが主催者の取り分を上回るほどではないからである。(Semi-)Strong Formに関しては、公式または非公式の予想記者によるバイアスは一般人によるものより大きい。
Figlewski(1979)は多項ロジットモデルで勝率と予想記者と最終オッズを関係付けた。予想記者の助言はかなりの情報を含んでいるがオッズがほぼ全てを割り引いてしまう。しかし、場外投票の場合は予想記者の主観的情報を完全には割り引いていない。Losey and Talbott(1980)はSynder(1978)のデータを解析し、予想記者を信じている競馬ファンは平均的リターンを得られないばかりかそれ以下であるとした。
Asch,Malkiel and Quandt(1982)は人気でのF-Lバイアスに加え、予想オッズより最終オッズのほうが勝率を評価するのに正確であると指摘。それは驚くべきことではない。なぜなら、オッズは大多数の人々のコンセンサスなのに対し、予想オッズは数名の予想記者が発表したもので、レースのスタートよりかなり以前だからである。
F-Lバイアスは弱くて現実的なリターンを生まないかもしれないが、その存在は説明する価値がある。合理的な投票者にもとづく2つのアプローチはリスク選好の競馬ファンの存在にもとづくものと確率に関する評価の分散を考慮するものである。
Part III:経済学的、数学的な考察
Issac(1953)の原論分からはじめる。競馬ファンが真の勝率を知っているとし、期待リターンを最大にするとする。Issacはオッズへの競馬ファンの影響を考慮し、最適な賭け金を決定する天才的なアルゴリズムを開発した。
Issacのモデルの3つの発展:
(1)Issacはリスク中立を仮定したが、Beriman(1961)は対数関数の効用関数を仮定して、富の成長率が最大化されることを示した。
(2)勝率をファンダメンタルやテクニカルの手法で評価すること。
(3)Issacの単勝馬券での議論を複勝やExotic馬券の場合に拡張するために、複数の馬がある順序でフィニッシュする確率の評価方法。
(1)Kelly基準(1956)とは富の対数の期待値を最大化するものである。おのおのの期間でk種類の投資機会がおきうるとし、どれが起きるかの確率はiidとする。各期間後の富の対数の期待値を各期間で最大化する戦略の3つの重要な性質は(1)資本の漸近的成長率を最大化する(2)あるゴールに達するまでの時間の期待値を最小化する (3)長い期間だと、他の本質的に異なる戦略の成績をほぼ確実にうわまわる。また、資本の成長を最大化するのではなく、安全を最大化するように戦略を発展させることができる。投資の部分を減らすことで成長と引き換えに安全性が増す。
(2)勝率を評価する方法として市場価格の情報を見るテクニカルアプローチとファンダメンタルアプローチがある。Bolton and Chapman(1986)は馬、騎手、レース特性の情報で多項ロジットモデルを開発した。しかし、その勝ちの評価で利益を生む戦略を発展させる可能性はとぼしかった。Chapman(1994)はさらに頑張った。
(3)複勝やExotic馬券を扱うには複数の馬がある順番でフィニッシュする確率を評価する必要がある。馬の勝率を知っているとして、Harville(1973)は馬i(勝率Pi)と馬j(勝率Pj)が12フィニッシュの確率Pijの非常に単純な評価方法を提案した。
Pij=PiPj/(1-Pi)
この評価は、馬iが1着の条件下で馬jが2着の条件付確率が馬iがいない状況での馬jの勝率に等しいから来ている。Silky Sullivan問題の可能性を考慮していない。1着かそれ以外なら賞金がない着順でと考える馬がいて、こうした馬では公式は2着、3着率を過大評価してしまう。Harvilleは、公式が2着、3着率に対し逆F-Lバイアス、人気馬の23着率を過大評価、弱い馬の23着率の過小評価になることを指摘した。走破時間が指数分布、正規分布、ガンマ分布従うとしてHarvilleモデルを修正する試みが多数存在するが計算時間が膨大になり実用性に乏しい。
Issacのモデルの3つの発展:
(1)Issacはリスク中立を仮定したが、Beriman(1961)は対数関数の効用関数を仮定して、富の成長率が最大化されることを示した。
(2)勝率をファンダメンタルやテクニカルの手法で評価すること。
(3)Issacの単勝馬券での議論を複勝やExotic馬券の場合に拡張するために、複数の馬がある順序でフィニッシュする確率の評価方法。
(1)Kelly基準(1956)とは富の対数の期待値を最大化するものである。おのおのの期間でk種類の投資機会がおきうるとし、どれが起きるかの確率はiidとする。各期間後の富の対数の期待値を各期間で最大化する戦略の3つの重要な性質は(1)資本の漸近的成長率を最大化する(2)あるゴールに達するまでの時間の期待値を最小化する (3)長い期間だと、他の本質的に異なる戦略の成績をほぼ確実にうわまわる。また、資本の成長を最大化するのではなく、安全を最大化するように戦略を発展させることができる。投資の部分を減らすことで成長と引き換えに安全性が増す。
(2)勝率を評価する方法として市場価格の情報を見るテクニカルアプローチとファンダメンタルアプローチがある。Bolton and Chapman(1986)は馬、騎手、レース特性の情報で多項ロジットモデルを開発した。しかし、その勝ちの評価で利益を生む戦略を発展させる可能性はとぼしかった。Chapman(1994)はさらに頑張った。
(3)複勝やExotic馬券を扱うには複数の馬がある順番でフィニッシュする確率を評価する必要がある。馬の勝率を知っているとして、Harville(1973)は馬i(勝率Pi)と馬j(勝率Pj)が12フィニッシュの確率Pijの非常に単純な評価方法を提案した。
Pij=PiPj/(1-Pi)
この評価は、馬iが1着の条件下で馬jが2着の条件付確率が馬iがいない状況での馬jの勝率に等しいから来ている。Silky Sullivan問題の可能性を考慮していない。1着かそれ以外なら賞金がない着順でと考える馬がいて、こうした馬では公式は2着、3着率を過大評価してしまう。Harvilleは、公式が2着、3着率に対し逆F-Lバイアス、人気馬の23着率を過大評価、弱い馬の23着率の過小評価になることを指摘した。走破時間が指数分布、正規分布、ガンマ分布従うとしてHarvilleモデルを修正する試みが多数存在するが計算時間が膨大になり実用性に乏しい。
Part II: 競馬ファンの効用関数とリスク選好
競馬での賭けは不確実下での意思決定の古典的な例である。各自が考える確率は主観的なものであって、客観的なものではない。多量のデータによって各自の確率を修正し、パリーミュチュエル方式でこれらの各自の評価を集計し最終的にオッズが決まる。それは客観的確率と大体一致している。この節の論文は、競馬ファンの効用関数を評価する。
最初に2,3の基礎的な事項。凸な効用関数はリスク回避的な振る舞いに説明を与える、保険に入ることを合理化する。凹な効用関数はリスク選好の振る舞いを説明し、競馬ファンの行動を合理化する。保険に入る一方でギャンブルも行う。それは一般的なことだけれど、これを合理的な行動として説明することは難しい。Friedman and Savage(1948)、Markowitz(1951)による説明は、低い富、高い富では凸、中ぐらいの富では凹な効用関数を用いることである。現在の富が、低い富と中ぐらいの富の境目となる。
競馬ファンの効用関数を調べたのはWeitzman(1965)に始まる。彼は、Mr.Avmart(平均的な競馬ファン)が競馬ファン全体を代表すると仮定し、リターンとMr.Avmartの効用関数の間の関係をデータをもとに決定した。得られた効用関数は凹となった。
競馬ファンの賭け方を説明するのに期待効用のアプローチを使う研究者は一般に競馬ファンはリスク選好者と結論し、それが、F-Lバイアスを説明するとする。他の説明も可能である。高確率を過小評価、低確率を過大評価するというバイアスでも同じパターンになる。
最初に2,3の基礎的な事項。凸な効用関数はリスク回避的な振る舞いに説明を与える、保険に入ることを合理化する。凹な効用関数はリスク選好の振る舞いを説明し、競馬ファンの行動を合理化する。保険に入る一方でギャンブルも行う。それは一般的なことだけれど、これを合理的な行動として説明することは難しい。Friedman and Savage(1948)、Markowitz(1951)による説明は、低い富、高い富では凸、中ぐらいの富では凹な効用関数を用いることである。現在の富が、低い富と中ぐらいの富の境目となる。
競馬ファンの効用関数を調べたのはWeitzman(1965)に始まる。彼は、Mr.Avmart(平均的な競馬ファン)が競馬ファン全体を代表すると仮定し、リターンとMr.Avmartの効用関数の間の関係をデータをもとに決定した。得られた効用関数は凹となった。
競馬ファンの賭け方を説明するのに期待効用のアプローチを使う研究者は一般に競馬ファンはリスク選好者と結論し、それが、F-Lバイアスを説明するとする。他の説明も可能である。高確率を過小評価、低確率を過大評価するというバイアスでも同じパターンになる。
Part 1:心理学的研究
競馬市場は投資家のリスク行動の心理学的な研究の場を提供する。Metzger(1985)が指摘するように、研究室での研究と比較して少なくとも4つの長所がある。
1.データが豊富で、バリエーションが豊か
2.賭け金の額が高く経済学的に無視できない
3.多様な情報源から莫大な情報を得ることが可能
4.さまざまな馬券のタイプ
競馬という場のの欠点は、オッズが多くの競馬ファンの投票(決断結果)の集積したものであって、個々の行動は通常分からないこと。単勝市場において強く安定なF-Lバイアスが報告されたが、最初に報告したのは心理学者のGriffith(1949)。
Griffith(1949)は単勝オッズが主観的(心理学的)勝率を表すと考え、あるオッズカテゴリ中の勝ち馬の比率が客観勝率を表すと考え比較した。この二つの確率に一貫して不一致が見られるならば、競馬市場での賭けという特殊なテーマだけでなく、より一般的な確率の心理学の分野に光を照らすことになると考えた。結論は、最終オッズは平均すれば勝率の正確な目安となるけれど、人気馬はシステマティックに過小評価され、不人気馬は実力以上に買われるというF-Lバイアスが存在する。
McGlothlin(1956)は、一日のレース毎の調査を行った。最終の2レースに関して通常のバイアスからのズレを発見。第7レースは、その日のメインレースだが、人気馬に対する過小評価がほとんどない。第8の最終レースでは、大人気馬は過小評価、中人気馬は過大評価、不人気馬は過小評価。理由は、最終レースでその日の負けを取り返し、勝者として家路につくための戦略のためと考えられる。その戦略では、人気馬のオッズではその日の損を取り返すのは無理で、適度な勝率とその日の損失をカバーできるだけの大きなオッズから、中人気の馬に票が集まってしまう。Ali(1977)はリスク選好の効用関数で、この戦略を説明した。
Metzger(1985)は他の心理学的な仮説を検証した。
(1)ギャンブラーの誤謬:人気馬が勝ち続けると、人気馬が過小評価になる
(2)結果のframingの検証:?
(3)馬番バイアスの迷信:不慮の事故には注意を払わず、内側の馬番を過大評価する
1.データが豊富で、バリエーションが豊か
2.賭け金の額が高く経済学的に無視できない
3.多様な情報源から莫大な情報を得ることが可能
4.さまざまな馬券のタイプ
競馬という場のの欠点は、オッズが多くの競馬ファンの投票(決断結果)の集積したものであって、個々の行動は通常分からないこと。単勝市場において強く安定なF-Lバイアスが報告されたが、最初に報告したのは心理学者のGriffith(1949)。
Griffith(1949)は単勝オッズが主観的(心理学的)勝率を表すと考え、あるオッズカテゴリ中の勝ち馬の比率が客観勝率を表すと考え比較した。この二つの確率に一貫して不一致が見られるならば、競馬市場での賭けという特殊なテーマだけでなく、より一般的な確率の心理学の分野に光を照らすことになると考えた。結論は、最終オッズは平均すれば勝率の正確な目安となるけれど、人気馬はシステマティックに過小評価され、不人気馬は実力以上に買われるというF-Lバイアスが存在する。
McGlothlin(1956)は、一日のレース毎の調査を行った。最終の2レースに関して通常のバイアスからのズレを発見。第7レースは、その日のメインレースだが、人気馬に対する過小評価がほとんどない。第8の最終レースでは、大人気馬は過小評価、中人気馬は過大評価、不人気馬は過小評価。理由は、最終レースでその日の負けを取り返し、勝者として家路につくための戦略のためと考えられる。その戦略では、人気馬のオッズではその日の損を取り返すのは無理で、適度な勝率とその日の損失をカバーできるだけの大きなオッズから、中人気の馬に票が集まってしまう。Ali(1977)はリスク選好の効用関数で、この戦略を説明した。
Metzger(1985)は他の心理学的な仮説を検証した。
(1)ギャンブラーの誤謬:人気馬が勝ち続けると、人気馬が過小評価になる
(2)結果のframingの検証:?
(3)馬番バイアスの迷信:不慮の事故には注意を払わず、内側の馬番を過大評価する
イントロダクション
ギャンブルとはリスク下での意思決定である。特に興味深いのは、ギャンブルが金融市場の持つ複雑さの多くを持つとと同時に短期間に何度も繰り返されるので、多くの金融市場で一般的に可能なレベル以上に明確な解析を行うことが出来る。この性質のため、投資家集団の振る舞いを赤裸々に見ることがある場合には可能になり、それは市場の効率性の検証に関してもいえる。
競馬市場の研究を手短に述べておく。USでの競馬用語を採用する。通常6から12頭の馬がレースに参加し、いくつかの賭けの形式が存在する。単勝は1着をあてる、複勝馬券(place,show) とは2着(3着)以内に入る馬をあてるもの。単勝、複勝のような一頭の馬を指定する馬券の種類をストレート馬券。他に、エキゾティック馬券では、2頭以上の馬の結果を予想する。例えば、馬連は12着の馬のペアを、馬単は12着の馬のペアと順序をあてるものである。
もっとも単純なのは単勝である。Wiで馬iへの賭け金を、Wで賭け金総額、Qで配当金比率を表すと、QW/Wiが馬iに対する払戻金の倍率となる。Oi=QW/Wi-1と定義すると、馬iのオッズはOi to 1とか、Oi-1と表され、オッズOi-1の馬に1ドル賭けた時の払戻金は、最初の1ドルプラスOiドルとなる。馬iに対する賭け金の比率Wi/Wは単勝得票率と呼ばれる。しばしば競馬ファン全体での馬の勝率に対する評価と解釈される。なぜなら、利益を最大にする馬に人は賭けると考えられるからである。けれど、この本のいくつかの論文では単勝得票率のみがほぼ馬の真の勝率に等しくなることを示している。
1-Qはレース主催者の取り分である。そのお金の一部は税金として国に納められる。USではStストレート馬券の場合、14から19%である。(日本の26%のように、他の国ではもっと高いこともある。)エキゾティック馬券の場合は20-25%またはそれ以上である。
レースの間隔は通常20分。その時間の間に次のレースの賭けが行われる。ほとんどのレースでは単勝、複勝のオッズを公開し、これらの数字は毎分程度の間隔で更新される。エキゾティック馬券の場合は、組み合わせの数が膨大になるので、公開されてもその一部のみ。
この本の内容:
1.心理学的な研究
確率の評価におけるバイアス、ギャンブラーの誤謬、Framing?など。
2.競馬ファンの効用関数とリスク選好
競馬データを用いて凸な効用関数を求めた。期待効用を最大化からF-Lバイアスが再現される。
3.経済学的、数学的な考察
(1)最適な賭けの戦略(2)ファンダメンタルに基づく能力評価の方法(3)さまざまな順序の確率(順序確率)の評価方法
4.単勝市場の効率性とF-Lバイアス
競馬ファンの主観勝率と客観勝率にはF-Lバイアスがある。競馬ファンのリスク選好により説明可能。人気馬のオッズの高さを利用して儲けることは難しく、競馬単勝市場はweak form の効率市場である。F-Lバイアスの例外が日本、香港の市場である。
5.複勝馬券市場の効率性
6.エキゾティック馬券市場の効率性
7.英国連邦とアジアの競馬市場
多くの国ではパリ・ミュチュエル方式ではなく固定オッズを用いる。F-Lバイアスが存在する。
競馬市場の研究を手短に述べておく。USでの競馬用語を採用する。通常6から12頭の馬がレースに参加し、いくつかの賭けの形式が存在する。単勝は1着をあてる、複勝馬券(place,show) とは2着(3着)以内に入る馬をあてるもの。単勝、複勝のような一頭の馬を指定する馬券の種類をストレート馬券。他に、エキゾティック馬券では、2頭以上の馬の結果を予想する。例えば、馬連は12着の馬のペアを、馬単は12着の馬のペアと順序をあてるものである。
もっとも単純なのは単勝である。Wiで馬iへの賭け金を、Wで賭け金総額、Qで配当金比率を表すと、QW/Wiが馬iに対する払戻金の倍率となる。Oi=QW/Wi-1と定義すると、馬iのオッズはOi to 1とか、Oi-1と表され、オッズOi-1の馬に1ドル賭けた時の払戻金は、最初の1ドルプラスOiドルとなる。馬iに対する賭け金の比率Wi/Wは単勝得票率と呼ばれる。しばしば競馬ファン全体での馬の勝率に対する評価と解釈される。なぜなら、利益を最大にする馬に人は賭けると考えられるからである。けれど、この本のいくつかの論文では単勝得票率のみがほぼ馬の真の勝率に等しくなることを示している。
1-Qはレース主催者の取り分である。そのお金の一部は税金として国に納められる。USではStストレート馬券の場合、14から19%である。(日本の26%のように、他の国ではもっと高いこともある。)エキゾティック馬券の場合は20-25%またはそれ以上である。
レースの間隔は通常20分。その時間の間に次のレースの賭けが行われる。ほとんどのレースでは単勝、複勝のオッズを公開し、これらの数字は毎分程度の間隔で更新される。エキゾティック馬券の場合は、組み合わせの数が膨大になるので、公開されてもその一部のみ。
この本の内容:
1.心理学的な研究
確率の評価におけるバイアス、ギャンブラーの誤謬、Framing?など。
2.競馬ファンの効用関数とリスク選好
競馬データを用いて凸な効用関数を求めた。期待効用を最大化からF-Lバイアスが再現される。
3.経済学的、数学的な考察
(1)最適な賭けの戦略(2)ファンダメンタルに基づく能力評価の方法(3)さまざまな順序の確率(順序確率)の評価方法
4.単勝市場の効率性とF-Lバイアス
競馬ファンの主観勝率と客観勝率にはF-Lバイアスがある。競馬ファンのリスク選好により説明可能。人気馬のオッズの高さを利用して儲けることは難しく、競馬単勝市場はweak form の効率市場である。F-Lバイアスの例外が日本、香港の市場である。
5.複勝馬券市場の効率性
6.エキゾティック馬券市場の効率性
7.英国連邦とアジアの競馬市場
多くの国ではパリ・ミュチュエル方式ではなく固定オッズを用いる。F-Lバイアスが存在する。
初版序文
競馬市場はギャンブラーやカジュアルな娯楽を求めている人々だけでなく、多肢にわたる分野の研究者にとっても興味を引くテーマである。ギャンブラーや投資家にとって競馬は面白いスポーツであり、利益の追求にも挑戦する。学者たちはこの挑戦に興味がある。彼らのアプローチは競馬市場が効率的なのかどうか、もしそうでないならリスク分を補正しても正のリターンを得ることが可能なのかを明らかにすることである。それに加え、競馬データを解析する手法、こみいった事象が起きる確率の決定、ギャンブラーの振る舞いの説明、賭けの戦略の開発も活発な研究分野である。競馬市場が面白いのは、効率性やギャンブラーの振る舞いの問題を議論する場を与えるだけでなく、簡単にアクセス可能な世界中のデータがこれらの疑問の検証を可能とするからである。
競馬に関する研究は過去40年以上に渡り学術雑誌に発表されてきた。近年、論文数は増加傾向にある。かなりの間、その経済学的、心理学的、財務的、統計的、そして数理的な側面をカバーする書籍が待望されてきた。この論文集は、さまざまな分野の世界中の研究者達との共同作業の結果である。この本は二通りの読者を想定する。競馬に興味のある研究者と競馬の学術的な研究について知りたいと考える一般読者である。
イントロダクションに続いて、7つのセクションが連なる。
(1)心理学的な研究
(2)競馬ファンの効用関数とリスク選好
(3)経済学または数学的な考察
(4)単勝市場の効率性とFavorite-Longshot(F-L)バイアス
(5)複勝馬券市場(placeとshow)の効率性
(6)エキゾチック馬券市場の効率性
(7)英国連邦とアジアの競馬市場の研究
である。
競馬に関する研究は過去40年以上に渡り学術雑誌に発表されてきた。近年、論文数は増加傾向にある。かなりの間、その経済学的、心理学的、財務的、統計的、そして数理的な側面をカバーする書籍が待望されてきた。この論文集は、さまざまな分野の世界中の研究者達との共同作業の結果である。この本は二通りの読者を想定する。競馬に興味のある研究者と競馬の学術的な研究について知りたいと考える一般読者である。
イントロダクションに続いて、7つのセクションが連なる。
(1)心理学的な研究
(2)競馬ファンの効用関数とリスク選好
(3)経済学または数学的な考察
(4)単勝市場の効率性とFavorite-Longshot(F-L)バイアス
(5)複勝馬券市場(placeとshow)の効率性
(6)エキゾチック馬券市場の効率性
(7)英国連邦とアジアの競馬市場の研究
である。
はじめに+第2版の序文

D.B.Hausch, V.SY. Lo and W.T.Ziemba 編集の競馬研究の論文集 「Efficiency of Racetrack Betting Market」の要約です。経済学が専門ではないため、誤訳も多々あるかと思います。ご指摘を頂ければ幸いです。
第2版序文
目標は競馬市場の効率性に関する最新かつ包括的な論文集である。初版(1994年)が絶版になったころから、ヘッジファンドのような組織がそこに書かれたアイデアをもとに数百万ドルの利益をあげ、利益の総額は計100億ドルに上る。初版はカルトアイテムとなり、その希少性、内容、そして投資グループの夢がeBay やアマゾンでの古書の値段を数千ドルまでに引き上げた。第2版(2008年)も初版とこの序文を除いて同じである。2000年前後からの競馬市場の変化として重要なものは、以下の4点である。
1.賭け金に対する割り引きが一般になった。大量購入者への見返りとして始まり、通常の13-30%の競馬場の取り分が正味10%になる。
2.場外馬券売り場、他の投票方法からの投票の比率が現在では87%。50%の投票の結果がオッズに反映されるのはレース出走後。
3.1999年に始まったBetfairなどの賭博交換市場(betting exchanges)では、主催者に対してではなく他の賭博者に対して賭けることで、さまざまな馬券のオッズを固定することが可能となった。ギャンブラーはパリ・ミュチュエル方式でのオッズの変化というリスクから逃れることができる。さらに、売り(ショート)ポジションをとるこもも可能である。
4.Favorite-Longshot(F-L)バイアス(人気馬の実力が過小評価されてオッズが高く、オッズの高い弱い馬は実力以上に買われているというバイアス)については、その程度は近年小さくなっている。
また、過去の仕事に対する拡張も行われた。たとえば、123着のような連続した着順での確率(順序確率)の計算をHarvilleの公式よりもよい精度で与える仕事がある。
登録:
投稿 (Atom)